El fin de la hegemonía textual: con Gemini 3, el GEO se vuelve multimodal
Hasta ahora, el Generative Engine Optimization (GEO) se centraba esencialmente en el texto: estructurar la semántica, afinar las entidades nombradas y trabajar la retórica para convencer a los LLM.
Antoine HeftlerCofundador
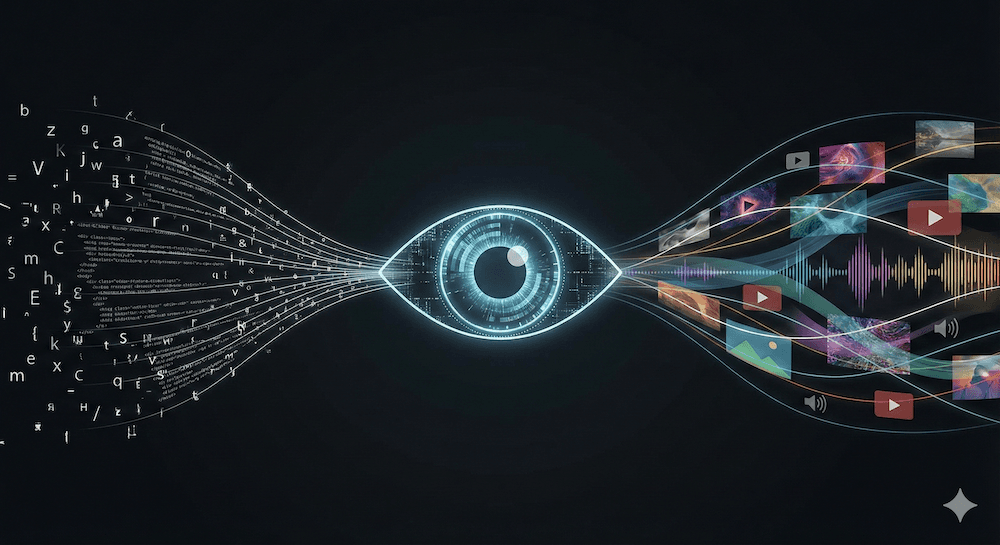
Hasta ahora, el Generative Engine Optimization (GEO) se centraba esencialmente en el texto: estructurar la semántica, afinar las entidades nombradas y trabajar la retórica para convencer a los LLM. Esa era ha terminado. La llegada de modelos nativamente multimodales significa que la IA ya no solo «lee» la web: la mira y la escucha. Para las marcas, eso impone una redefinición inmediata de lo que constituye una «fuente» a ojos de los motores de respuesta.
1. La imagen ya no es una ilustración: es un dato
Durante mucho tiempo tratamos los visuales (imágenes, infografías, vídeos) como elementos de «confianza» para la persona o de decoración para la interfaz. Para una IA como Gemini 3, esos elementos se convierten en datos brutos que interpretar.
La trayectoria técnica ya estaba trazada. En septiembre de 2025, Mistral AI demostraba con Pixtral-12B lo fulgurante de los avances en visión por ordenador: gracias a la adaptación LoRA, la precisión del modelo sobre imágenes de satélite pasaba del 56 % al 91 %. Ese salto cuantitativo prueba que los modelos ya no se conforman con agregar metadatos (el texto alternativo): analizan la sustancia misma de la imagen para detectar desviaciones y separar lo fiable de lo aproximado.
Si su contenido textual afirma una pericia que sus visuales contradicen por su genericidad o su incoherencia, la IA degradará su puntuación de autoridad.
2. La extensión de la noción de «fuente»
El mantra de la IA sigue intacto: «fuentes, fuentes, fuentes». El perímetro de esas fuentes, sin embargo, se extiende ahora a su corpus visual y de vídeo.
Un vídeo de demostración técnica o una entrevista con un experto ya no son simples «contenidos ricos». Se convierten en pruebas de autoridad que el motor indexa para validar una respuesta. Una marca que no cartografía las situaciones de uso de sus productos —también en lo visual— quedará sistemáticamente por detrás.
El riesgo es la dilución: si sus activos visuales (owned y earned) no están concebidos como puntos de anclaje fiables, la IA los hundirá en un relato incierto. El GEO debe integrar por tanto una semántica visual: ¿llevan sus imágenes los mismos atributos de marca que sus textos?
3. Hacia una coherencia narrativa total
Esta transición hacia lo multimodal obliga a las empresas a romper los silos entre los equipos de «brand», «content» y «SEO». La IA no hace esa distinción: busca construir lo plausible, a veces en detrimento de lo verdadero.
Si la IA percibe una disonancia entre el texto (la promesa) y la imagen (la prueba), introducirá un «desenfoque» en la restitución de la marca. En lógica difusa, como en el GEO, el objetivo es maximizar la probabilidad de ser citado como referencia y pasar de 0,55 a 0,92 en la asociación con una pericia dada.
La pregunta ya no es solo «¿qué hemos escrito?», sino «¿qué damos a ver y a oír que confirme nuestra autoridad?». La optimización para los motores generativos se convierte en un ejercicio de coherencia total.