La fin de l'hégémonie textuelle : Avec Gemini 3, le GEO devient multimodal
Jusqu'ici, le Generative Engine Optimization (GEO) se concentrait essentiellement sur le texte : structurer la sémantique, affiner les entités nommées et travailler la rhétorique pour convaincre les LLM.
Antoine HeftlerCo-fondateur
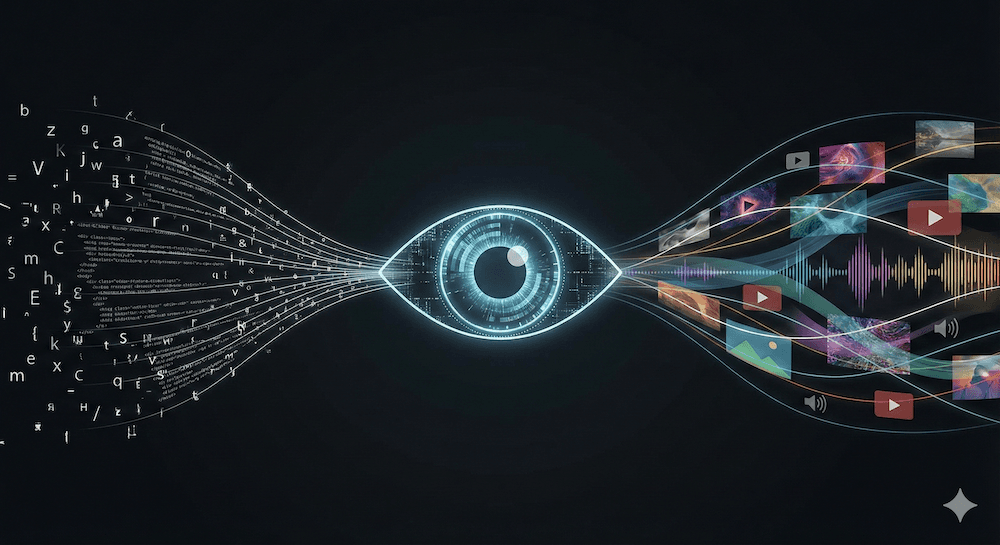
Jusqu'ici, le Generative Engine Optimization (GEO) se concentrait essentiellement sur le texte : structurer la sémantique, affiner les entités nommées et travailler la rhétorique pour convaincre les LLM. Cette ère est révolue. L'arrivée de modèles nativement multimodaux signifie que l'IA ne "lit" plus seulement le web ; elle le regarde et l'écoute. Pour les marques, cela impose une redéfinition immédiate de ce qui constitue une "source" aux yeux des moteurs de réponse.
1. L'image n'est plus une illustration, c'est une donnée
Nous avons longtemps traité les visuels (images, infographies, vidéos) comme des éléments de "réassurance" pour l'humain ou de décoration pour l'interface. Pour une IA comme Gemini 3, ces éléments deviennent des données brutes à interpréter.
La trajectoire technique était déjà tracée. En septembre 2025, Mistral AI démontrait avec Pixtral-12B la fulgurance des progrès en vision par ordinateur : grâce à l'adaptation LoRA, la précision du modèle sur l'imagerie satellite passait de 56 % à 91 %. Ce bond quantitatif prouve que les modèles ne se contentent plus d'agréger des métadonnées (le texte alternatif) ; ils analysent la substance même de l'image pour repérer les écarts et trier le fiable de l'approximatif.
Si votre contenu textuel affirme une expertise que vos visuels contredisent par leur généricité ou leur incohérence, l'IA dégradera votre score d'autorité.
2. L'extension de la notion de "Source"
Le mantra de l'IA reste immuable : « sources, sources, sources ». Cependant, le périmètre de ces sources s'étend désormais à votre corpus visuel et vidéo.
Une vidéo de démonstration technique ou une interview d'expert ne sont plus de simples "contenus riches". Elles deviennent des preuves d'autorité que le moteur indexe pour valider une réponse. Une marque qui ne cartographie pas les situations d'usage de ses produits — y compris visuellement — sera systématiquement devancée.
Le risque est celui de la dilution : si vos actifs visuels (owned et earned) ne sont pas conçus comme des points d'ancrage fiables, l'IA les noiera dans un récit incertain. Le GEO doit donc intégrer une sémantique visuelle : vos images portent-elles les mêmes attributs de marque que vos textes ?
3. Vers une cohérence narrative totale
Cette transition vers le multimodal force les entreprises à briser les silos entre les équipes "brand", "content" et "SEO". L'IA ne fait pas la distinction : elle cherche à construire du plausible, parfois au détriment du vrai.
Si l'IA perçoit une dissonance entre le texte (promesse) et l'image (preuve), elle introduira un "flou" dans la restitution de la marque. Or, en logique floue comme en GEO, le but est de maximiser la probabilité d'être cité comme référence, de passer de 0,55 à 0,92 dans l'association à une expertise donnée.
La question n'est plus seulement « qu'avons-nous écrit ? », mais « que donnons-nous à voir et à entendre qui confirme notre autorité ? ». L'optimisation pour les moteurs génératifs devient un exercice de cohérence totale.