Das Ende der Texthegemonie: Mit Gemini 3 wird GEO multimodal
GEO drehte sich vor allem um Text. Mit Gemini 3 zählen Bilder und andere Formate dafür, wie KI-Engines eine Quelle zum Zitieren auswählen.
Antoine HeftlerMitgründer
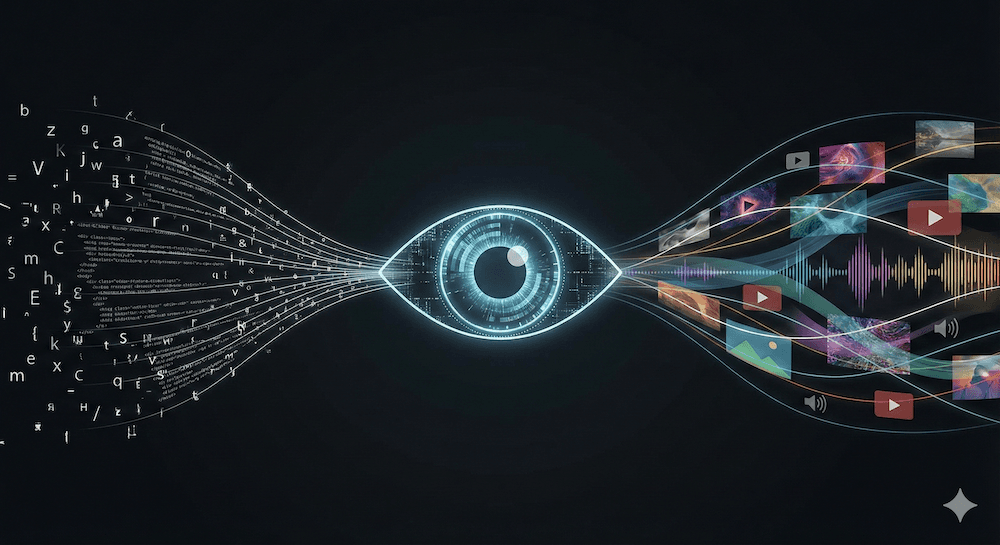
Bisher konzentrierte sich Generative Engine Optimization (GEO) im Wesentlichen auf Text: Semantik strukturieren, benannte Entitäten schärfen und die Rhetorik formen, die LLMs (große Sprachmodelle) überzeugt. Diese Ära ist vorbei. Mit dem Aufkommen nativ multimodaler Modelle „liest“ KI das Web nicht mehr nur. Sie sieht es an und hört ihm zu. Für Marken erzwingt das eine sofortige Neubestimmung dessen, was in den Augen der KI-Engines als „Quelle“ zählt.
1. Das Bild ist keine Illustration mehr. Es sind Daten
Lange haben wir Visuals (Bilder, Infografiken, Videos) als „Beruhigung“ für Menschen behandelt oder als Schmuck der Oberfläche. Für eine KI wie Gemini 3 werden diese Elemente zu Rohdaten, die zu interpretieren sind.
Der technische Weg war bereits vorgezeichnet. Im September 2025 zeigte Mistral AI mit Pixtral-12B, wie schnell das maschinelle Sehen voranschritt: Dank einer Anpassung per LoRA (Low-Rank Adaptation) sprang die Genauigkeit des Modells bei Satellitenbildern von 56 % auf 91 %. Dieser quantitative Sprung belegt, dass Modelle sich nicht mehr damit begnügen, Metadaten zu aggregieren (den Alt-Text). Sie analysieren die Substanz des Bildes selbst, um Abweichungen zu erkennen und das Verlässliche vom Ungefähren zu scheiden.
Wenn Ihr Text eine Expertise beansprucht, der Ihre Bilder widersprechen, weil sie generisch oder uneinheitlich sind, stuft die KI Ihren Autoritätswert herab.
2. Der Begriff der Quelle weitet sich aus
Das Mantra der KI bleibt unverändert: „Quellen, Quellen, Quellen.“ Der Umkreis dieser Quellen reicht nun jedoch bis zu Ihrem Korpus aus Bildern und Videos.
Ein technisches Demonstrationsvideo oder ein Experteninterview ist nicht mehr bloß „reiche Inhalte“. Es wird zum Beleg der Autorität, den die KI-Engine indexiert, um eine Antwort zu validieren. Eine Marke, die die Situationen nicht kartiert, in denen ihre Produkte genutzt werden — auch visuell —, wird systematisch überholt.
Das Risiko ist die Verwässerung. Wenn Ihre visuellen Inhalte (eigene und verdiente) nicht als verlässliche Ankerpunkte angelegt sind, versenkt die KI sie in einer unsicheren Erzählung. GEO muss daher eine visuelle Semantik einschließen: Tragen Ihre Bilder dieselben Markenattribute wie Ihre Texte?
3. Hin zu vollständiger narrativer Kohärenz
Dieser Wechsel zum Multimodalen zwingt Unternehmen, die Silos zwischen den Teams für „Marke“, „Inhalte“ und „SEO“ aufzubrechen. KI macht diese Unterscheidung nicht. Sie versucht, das Plausible aufzubauen, manchmal auf Kosten des Wahren.
Wenn die KI eine Dissonanz zwischen dem Text (dem Versprechen) und dem Bild (dem Beleg) wahrnimmt, bringt sie eine „Unschärfe“ in die Darstellung der Marke. In der Fuzzy-Logik wie im GEO geht es darum, die Wahrscheinlichkeit zu maximieren, als Referenz zitiert zu werden, und in der Verbindung mit einer bestimmten Expertise von 0,55 auf 0,92 zu steigen.
Die Frage lautet nicht mehr nur „Was haben wir geschrieben?“. Sie lautet „Was geben wir dem Modell zu sehen und zu hören, das unsere Autorität bestätigt?“ Die Optimierung für KI-Engines wird zu einer Übung in vollständiger Kohärenz.
Die GEO-Methode an einem Fall sehen
Unsere Beispielanalyse zeigt eine fiktive Marke, aufgebaut aus den Zahlen und Ergebnissen echter Analysen. Danach können Sie die GEO-Tools am Markt vergleichen.